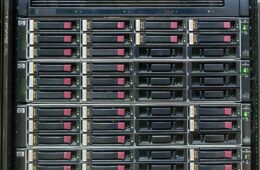

Когато говорим за възстановяване на данни от RAID масив, често се приема, че всичко се свежда до това да свържем дисковете, да определим RAID нивото и да ги подредим в правилния ред.
При стандартни RAID конфигурации това понякога е сравнително близо до истината. При enterprise storage системи обаче ситуацията може да бъде коренно различна.
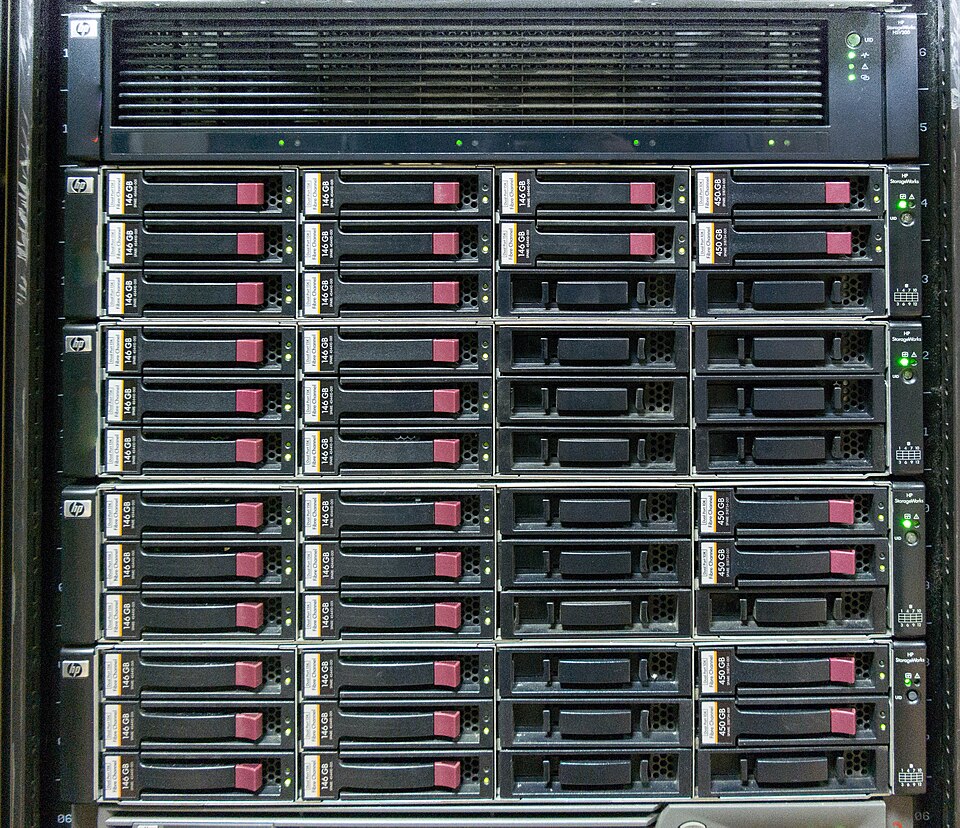
Системи като HP EVA, IBM Storwize и други висок клас storage платформи използват сложна вътрешна архитектура, при която физическите дискове не представляват просто поредица от блокове, разпределени по предварително известна схема.
Точно това е една от основните причини професионалното възстановяване на данни от такива системи да бъде значително по-сложно и съответно по-скъпо.
RAID не означава непременно „данните са разделени на блокове между дисковете“
При класически RAID 0, RAID 5 или RAID 6 можем сравнително лесно да си представим логиката:
Disk 1 → блок A
Disk 2 → блок B
Disk 3 → блок C
Disk 4 → parity
При определена конфигурация и известен stripe size може да се реконструира логическият масив. При enterprise storage системите тази картина често е прекалено опростена.
Вместо директно разпределение на логическите блокове върху физическите дискове може да има
няколко слоя виртуализация и транслация между потребителските данни и физическите блокове.
Устройството, което операционната система вижда като един логически volume, може да бъде резултат от сложна комбинация от:
- физически дискове;
- disk groups;
- storage pools;
- extents;
- виртуални дискове;
- вътрешни mapping таблици;
- metadata;
- relocation;
- redundancy;
- parity;
- контролерна логика;
- кеширани операции;
- firmware-specific структури.
Следователно физическото местоположение на даден логически блок не може просто да бъде изчислено чрез стандартна RAID формула.
Собствената транслация е ключът
При някои enterprise storage архитектури има допълнителен слой, който можем условно да наречем storage translation layer.
Той определя къде физически се намират частите от логическия volume. Например:
Logical Volume → Virtual Storage → Extent → RAID/Redundancy Group → Physical Disk → Physical location
Това означава, че дори да разполагаме с всички физически дискове, ние не разполагаме автоматично с информацията как да ги превърнем обратно в оригиналния логически volume.
Трябва да бъде възстановена и логиката, по която storage системата е организирала информацията.
Именно тук започва истинската сложност.
ZOR, Reed-Solomon и сложните алгоритми за redundancy
При висок клас storage системите защитата на данните също може да бъде много по-сложна от стандартния XOR parity, използван например при класически RAID 5.
В зависимост от архитектурата могат да се използват различни математически методи за redundancy и реконструкция, включително кодове от типа Reed-Solomon и други erasure coding подходи.
Тяхната задача е да позволят възстановяване на информацията дори когато определени физически компоненти са недостъпни.
При Reed-Solomon например информацията не се свежда до простото:
Data + XOR = Parity
Използват се математически операции върху полета и се създават множество redundancy фрагменти, чрез които могат да бъдат реконструирани липсващи части от данните.
При някои архитектури се срещат и Z-подобни/erasure coding механизми, различни варианти на parity и proprietary алгоритми.
Следователно при повреден масив трябва да се знае не само кои дискове са налични, но и как точно системата е генерирала и разпределяла redundancy информацията.
Най-големият проблем – данните не са там, където очаквате
Представете си, че имаме 12 диска. На пръв поглед можем да кажем:
„Имаме 12 диска – ще ги прочетем и ще възстановим RAID-а.“
Но при сложна storage система това може да е напълно погрешен подход.
Един логически блок от даден volume може да бъде разпределен чрез няколко нива на адресиране и да няма директна връзка между:
LBA на логическия volume
и
LBA на конкретния физически диск.
Освен това различни части на volume-а могат да бъдат разположени на различни места във физическата storage архитектура.
Затова простото „нареждане на дисковете“ често не води до нищо.
Защо стандартният RAID recovery софтуер често не е достатъчен?
При стандартен RAID софтуер можем да зададем параметри като:
- RAID 5;
- RAID 6;
- брой дискове;
- stripe size;
- disk order;
- parity rotation;
- offset.
При enterprise storage това може да бъде само малка част от необходимата информация. Необходимо е да се разбере:
как storage системата е създала логическия volume и как е извършвала транслацията към
физическите дискове.
Ако този mapping не бъде възстановен, получаваме огромно количество физически данни, но не и правилния логически volume.
Това е фундаменталната разлика между:
„имаме дисковете“
и
„имаме достъп до данните“.
HP EVA – пример за сложна storage архитектура
HP EVA (Enterprise Virtual Array) е добър пример защо enterprise storage възстановяването не трябва да се разглежда като обикновен RAID recovery.
При EVA физическите дискове са част от по-сложна виртуализирана storage архитектура.
Логическите дискове и volumes не са просто стандартни RAID масиви, които могат да бъдат реконструирани чрез няколко параметъра.
Има metadata и вътрешни структури, които описват организацията на storage пространството.
При повреда на контролери, metadata или множество дискове възстановяването може да изисква реконструкция на тази вътрешна организация.
IBM Storwize – още един пример
При IBM Storwize ситуацията е аналогична, но с допълнителна сложност от гледна точка на виртуализацията.
Storwize може да предоставя логически volumes, изградени върху физическа storage инфраструктура, която е скрита зад множество слоеве.
Така физическите дискове сами по себе си не дават достатъчно информация за това как операционната система е виждала данните.
Необходимо е да бъде възстановен правилният mapping между:
Physical Storage → Storage Pool → Extents → Volume → Logical Blocks
Ако този mapping е нарушен, възстановяването на файловата система на върха може да бъде невъзможно, независимо че голяма част от физическите дискове са технически четими.
Защо това прави възстановяването скъпо?
Причината не е просто „големият брой дискове“.
Цената идва от сложността на анализа и реконструкцията. При подобни системи може да се наложи:
диагностика на всеки физически диск;
извличане на firmware и metadata информация;
определяне на реалната конфигурация;
анализ на storage metadata;
реконструкция на вътрешната транслация;
определяне на разпределението на extents;
реконструкция на redundancy;
работа с повредени или липсващи дискове;
виртуално сглобяване на storage системата;
проверка на получените данни на ниво файлова система и файлове.
Това може да изисква много часове или дни специализирана работа, а понякога и разработване на специфична методика за конкретната система.
„Дисковете се четат“ не означава „данните могат да се възстановят“
Това е едно от най-честите недоразумения. Може да имаме:
12 от 12 физически диска – четими.
И въпреки това:
0% използваеми файлове.
Защо?
Защото физическите дискове са само суровият материал.
Трябва да знаем как този материал е бил организиран от storage системата.
Точно както притежаването на всички части на книга не означава автоматично, че знаем правилния ред на страниците, така и наличието на всички дискове не означава, че имаме готовия logical volume.
Enterprise storage recovery е отделна специалност
Възстановяването от стандартен RAID и възстановяването от enterprise storage система са две много различни задачи.
При стандартен RAID често можем да работим с добре известен алгоритъм. При enterprise системите може да имаме:
RAID/Erasure Coding + Virtualization + Translation + Metadata + Proprietary structures
и всеки от тези слоеве трябва да бъде правилно разбран и реконструиран.
Затова професионалното възстановяване на данни от системи като HP EVA, IBM Storwize и други enterprise storage платформи изисква не само специализиран софтуер, но и задълбочени познания за конкретната архитектура, опит с подобни случаи и подходяща апаратура.
Възстановяването не е просто „сглобяване на RAID“
При сложните storage системи най-трудната част често не е самото четене на дисковете.
Трудната част е да се разбере какво точно е направила системата с данните.
И когато липсва тази информация или тя е повредена, възстановяването може да се превърне в сложна реконструкция на цяла виртуална storage архитектура.
Именно затова възстановяването на данни от enterprise storage системи е значително по-скъпо от стандартното RAID възстановяване – необходимо е да бъде възстановен не само RAID-ът, а логиката, която превръща множеството физически дискове обратно в оригиналната система и нейните данни.